Прототип за вечер и рабочий ассистент — разная инженерия
Собрать демо несложно: подключаем модель, пишем системный промпт, задаём пару вопросов и получаем связные ответы. За вечер выходит демо, которое убедительно отвечает на общие темы. На этом этапе кажется, что ассистент готов к клиентам.
В работе этого мало. Клиент спрашивает про условия доставки, остаток на складе, порядок возврата — и ждёт ответ по фактам компании, с опорой на регламенты и прайс. Ассистенту нужно держать длинный диалог, не терять суть к десятой реплике и вовремя передавать клиента оператору. Эту часть демо не показывает — она всплывает, когда с ассистентом начинают говорить реальные люди.
Ниже — механика сборки: что внутри ассистента, как собирается ответ, где решение своими силами начинает ошибаться и какая обвязка приносит деньги. Деньги здесь — это поток сделок без потерянных заявок и ответы, которым можно доверять в денежных вопросах.
Из чего собран ассистент: схема RAG из четырёх частей
Чтобы модель отвечала по данным компании, ассистента строят по схеме RAG. В ней четыре части: база знаний, ретривер, слой интеграции и сама модель-генератор.
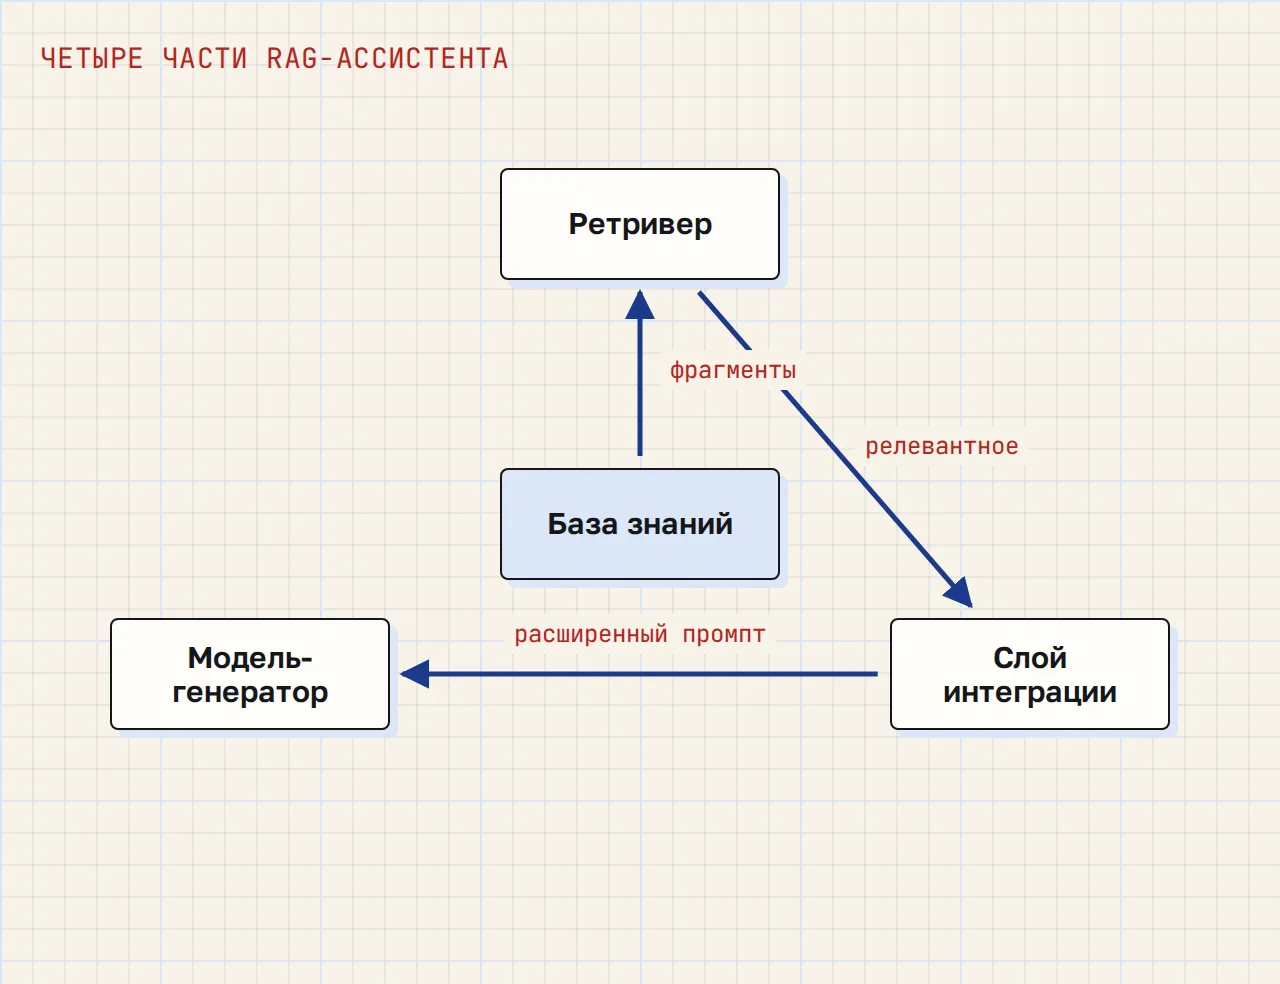
База знаний — это регламенты, прайсы, скрипты продаж, ответы на частые вопросы. Ретривер под конкретный вопрос клиента ищет в базе релевантные фрагменты. Слой интеграции вставляет найденное в промпт рядом с вопросом клиента. Модель формулирует ответ, опираясь на переданный контекст, и не придумывает факты от себя.
Пустой промпт без этой обвязки в работу не годится: опереться модели не на что, и она начинает домысливать. Общее описание схемы ведёт документация IBM.
Как ассистент находит нужный ответ
Механика пошаговая: вопрос клиента → поиск в базе знаний → возврат релевантных фрагментов → сборка расширенного промпта (вопрос плюс найденный контекст) → ответ модели.
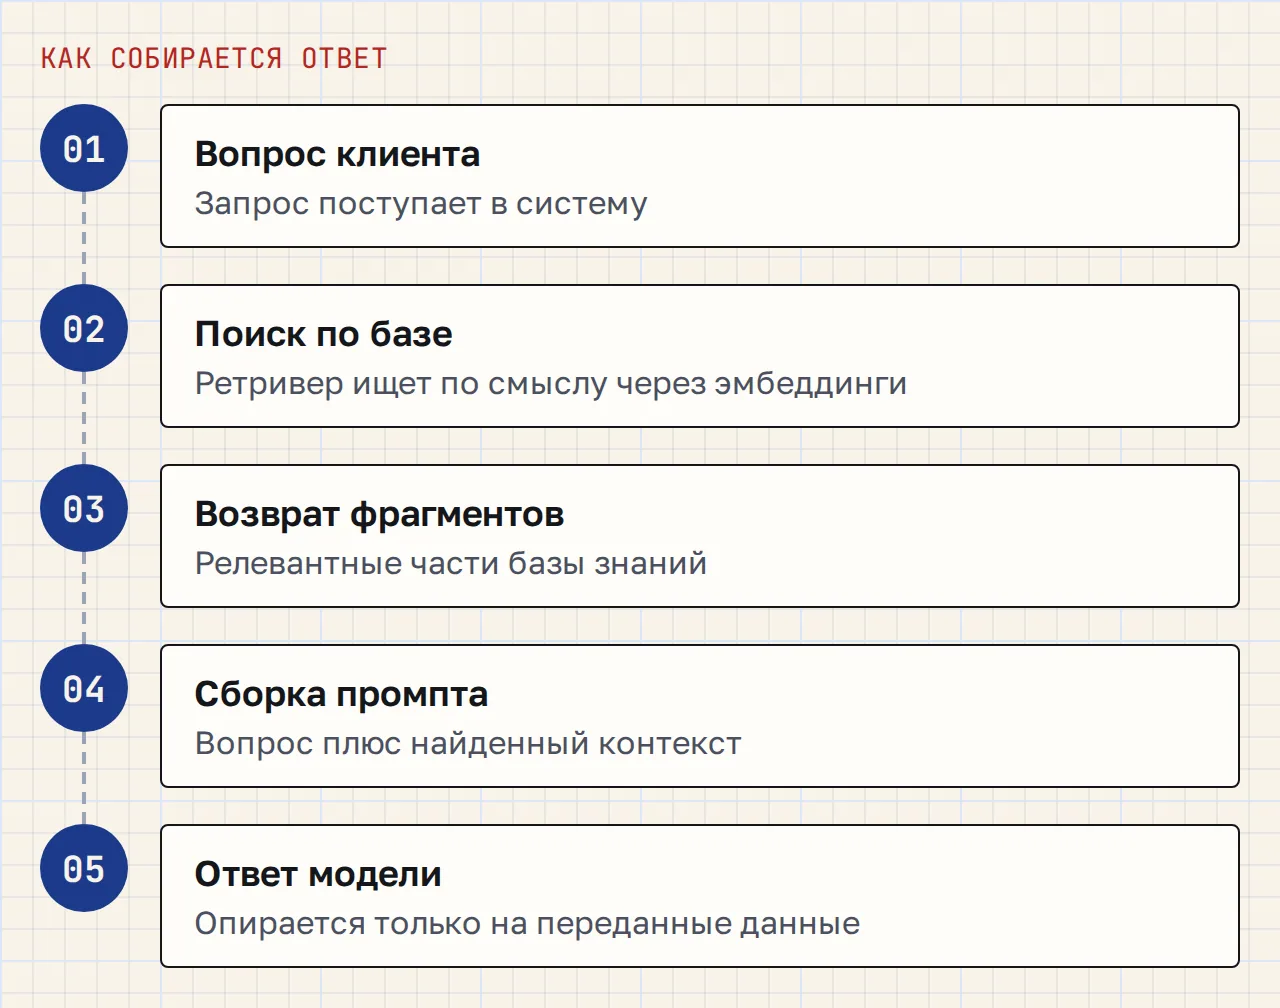
Поиск работает через эмбеддинги и векторную базу. Эмбеддинг — это числовое представление смысла фразы. Вопрос клиента переводится в вектор, система находит семантически близкие фрагменты базы и ранжирует их по близости. Совпадение идёт по смыслу, точные слова при этом могут отличаться, поэтому «вернуть товар» и «оформить возврат» выводят на одни и те же фрагменты базы.
Базу заранее режут на небольшие тематические фрагменты — ретривер находит точный фрагмент по теме запроса и передаёт только его в промпт. Отсюда два полезных для бизнеса эффекта. Ассистент может сослаться на источник ответа — видно, из какого документа взят факт, и ответ проверяем. Знания обновляются правкой базы: новый прайс или акция добавляются как документ, без дорогого переобучения модели.
Качество ответа определяет структура базы знаний, из которой тянется контекст, — больше, чем «ум» самой модели. Хорошо размеченная база с короткими тематическими документами даёт точные ответы даже на средней модели; плохо структурированная база даёт сбивчивые ответы даже на частые вопросы.
Где самостоятельная сборка подводит в работе
RAG снижает выдумки, привязывая ответ к проверенным данным. Безошибочной модель от этого не становится: она может неверно истолковать корректный источник, смешать два противоречащих документа или не признать, что ответа в базе нет, и выдать правдоподобную формулировку вместо честного «не знаю».
Для денежных вопросов — счета, условия договора, обязательства клиенту — в конструкцию закладывают ограничители и проверку. Ассистент не называет цену или срок, которых нет в базе; спорные темы уводятся на оператора. Слепое доверие ответу модели в таких местах оборачивается обещанием, которое компания не планировала давать.
Длинный контекст работает против точности. Когда нужный факт лежит в середине большого объёма текста, точность ответа падает примерно на 20–30 процентных пунктов по сравнению с ситуацией, когда факт стоит в начале или в конце, — эффект «lost in the middle». Вывод для сборки: точный поиск нужного фрагмента важнее попытки передать модели сразу всю базу и весь диалог.
Передача оператору как часть конструкции
Передачу человеку закладывают в ассистента с самого начала. Добавить её поверх готовой логики сложно: нужно заранее решить, по каким признакам диалог уходит оператору и как при этом передаётся контекст.
Эскалацию запускают по триггерам. Клиент не продвигается и повторяет один и тот же вопрос; тема выходит за рамки бота; в репликах появляется раздражение; или это высокоценный клиент, которого нельзя держать на боте. Типично ассистент передаёт диалог человеку после шести-восьми реплик без результата — по срокам ориентируются на материал Cognizant о передаче от бота к оператору.
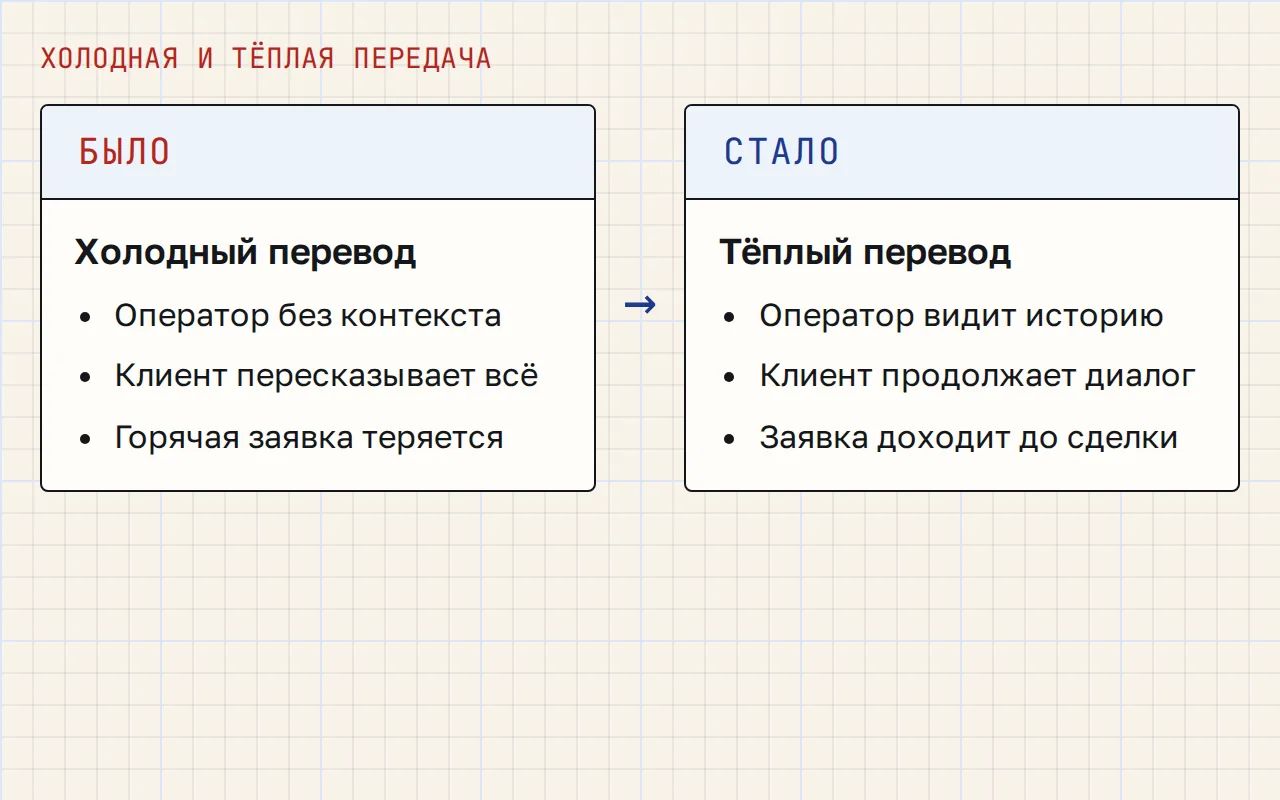
Перевод делают «тёплым»: оператор получает историю переписки и суть вопроса, клиент не пересказывает всё заново. Слабая передача оборачивается потерянной горячей заявкой — клиент уже прогрет, а его просят начать сначала, и он уходит к тому, кто ответит быстрее.
Когда хватает прототипа, а когда звать специалистов
Демо на вечер полезно, чтобы проверить идею и показать её коллегам. Для разовых справок по узкой теме такого ассистента иногда достаточно.
Под реальную воронку идёт решение с продуманной базой знаний, дисциплиной заземления ответов на источники, управлением контекстом и корректной эскалацией. Эта обвязка и окупается: поток сделок без потерянных заявок и ответы, на которые можно опереться в денежных разговорах. Когда ассистент — часть системы из нескольких ролей, связать эти роли между собой — отдельная задача; мы разбирали её в материале про систему ИИ-агентов.
Сборку ассистента, наполнение базы знаний и подключение к каналам и CRM мы берём на себя — разработка ИИ-ассистента под бизнес-процесс. Если задача ближе к работе отдела продаж — квалификация заявок, ответы на первой линии, подогрев клиента, — это ИИ в отделе продаж. Вход — бесплатный созвон, после него присылаем план и смету. Разбор ведёт Никита Бердников.

Автор
Лаборатория внедрений
Внедряем и сопровождаем amoCRM и Битрикс24, делаем интеграции, разработку и аналитику. Пишем о том, что видим на аудитах и в проектах.
О компании